不联网 · 不录音 · 不上传
模型下载到手机后,识别全程在手机本地完成,不需要建账号,也不需要保持联网。开飞行模式照样出字。
不是把语音识别塞进手机,而是按「听得清、看得懂、随时能用」重新做了一遍。
模型下载到手机后,识别全程在手机本地完成,不需要建账号,也不需要保持联网。开飞行模式照样出字。
轻快版模型边说边出字。一句话还没说完,字幕已经在屏幕上走,延迟低到能跟上正常语速的对话。
标点版模型支持中英混说,边说边补标点;「这个 project 的 deadline 是下周五」也能干净成句。
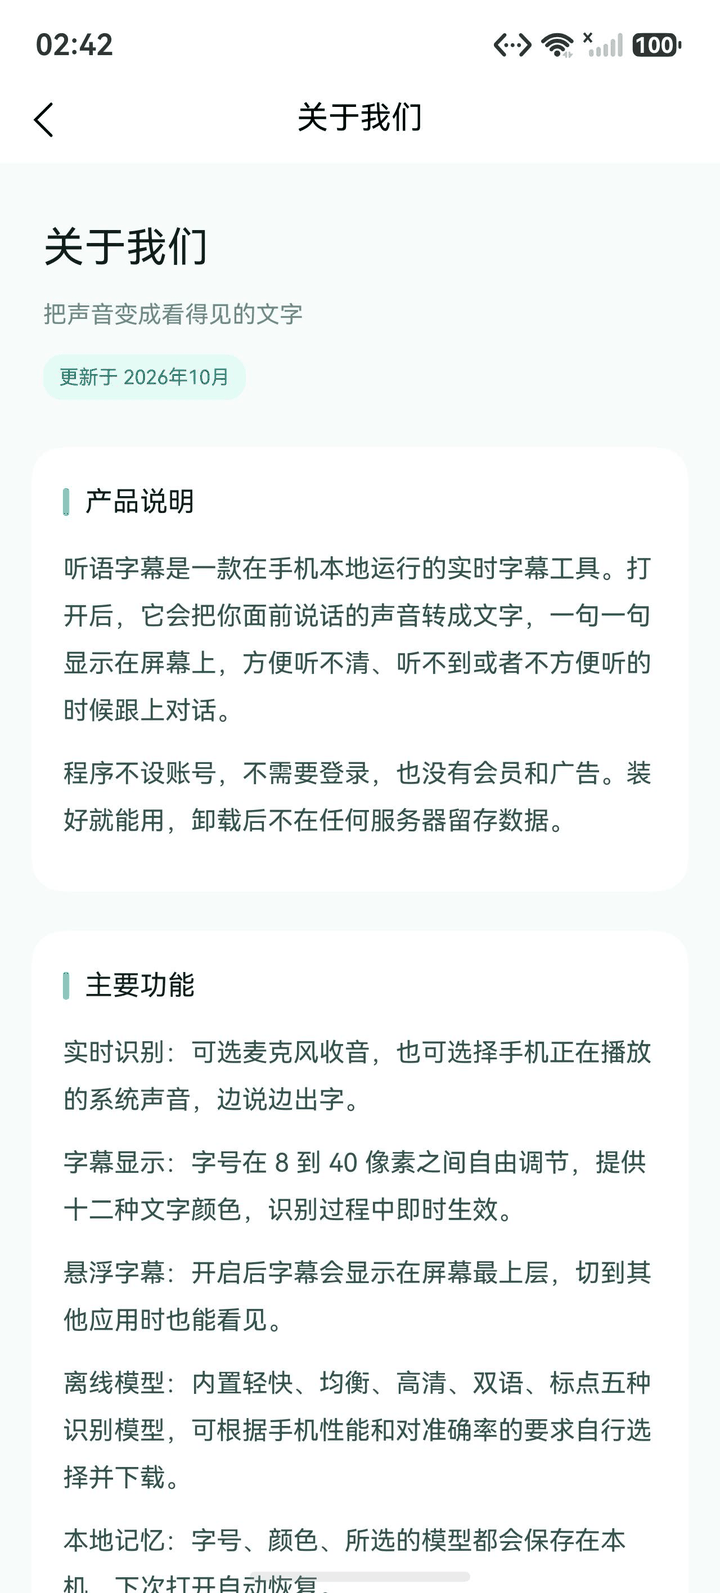
开启悬浮窗后,字幕条浮在屏幕最上层。追剧、上网课、切到别的 App 都不影响,字幕一直跟着你。
从 21MB 的轻快版到 209MB 的双语版,出字速度与准确率自己权衡。老手机也能稳稳跑起来。
8–40px 字号、12 种字色,识别过程中即时生效。暗光换浅色、强光换深色,看久也不累。
听不清、听不到、不方便听的场合,字幕能把对话留在屏幕上。
老师语速快、坐得远,字幕把每句话记下来,课后还能回看。
多人交替发言时不怕漏,中英混说也能准确落字。
医生说的注意事项一句句显示,不用反复确认,回家照着做。
把正在播放的声音转成字幕,没字幕的片源也能看懂。
环境嘈杂、对方声音轻,把手机放在桌上,字幕替你把话听清。
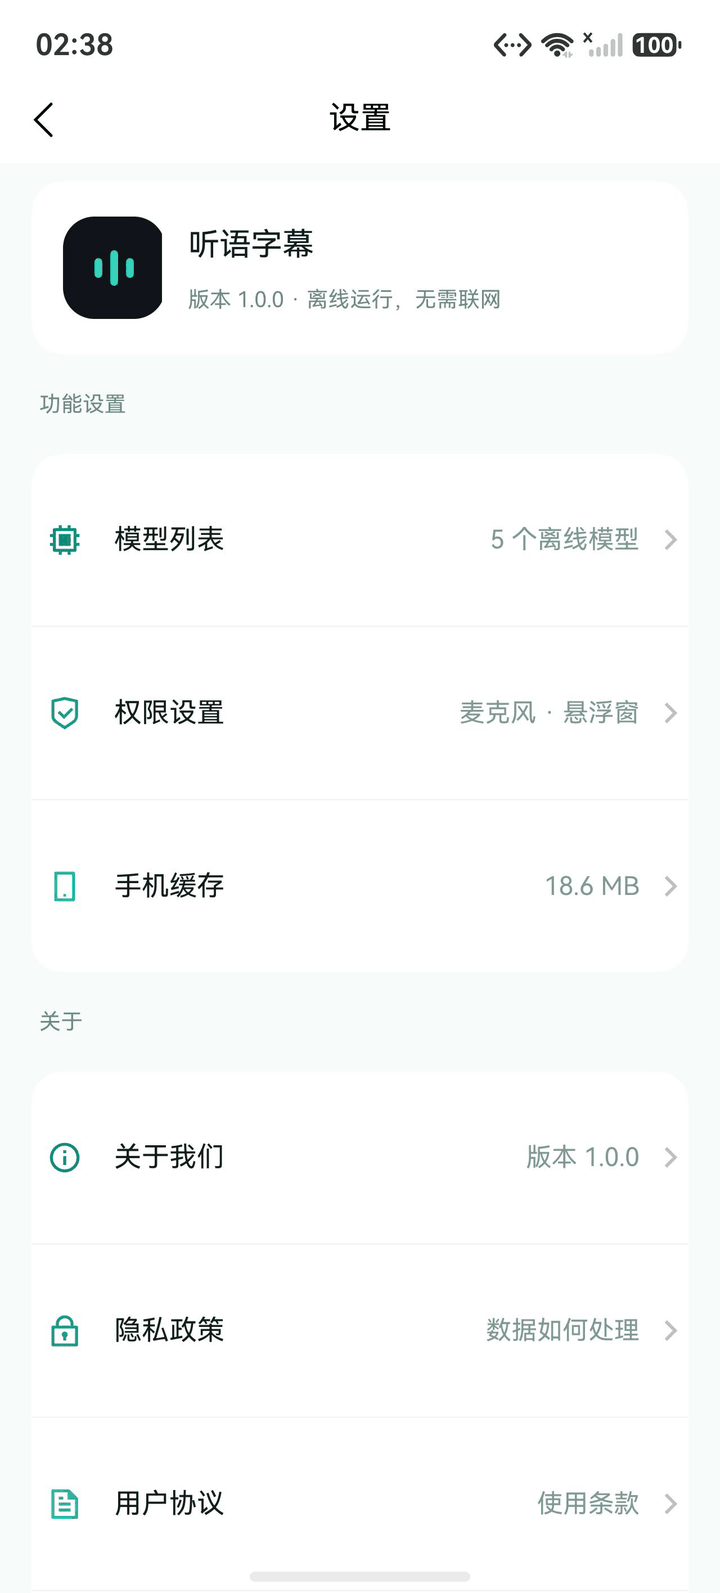
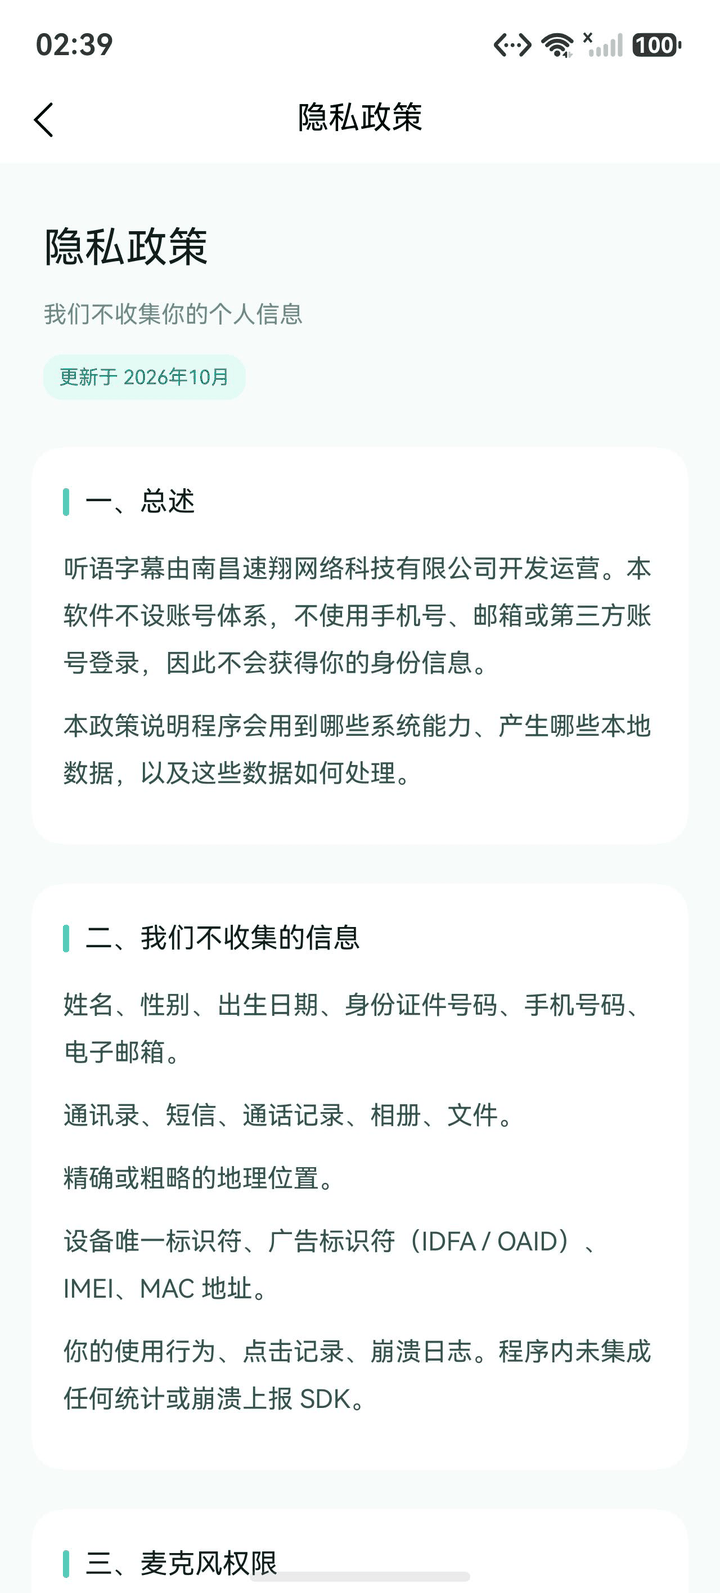
以下是 App 运行时的实际截图,左右滑动可以逐屏看。
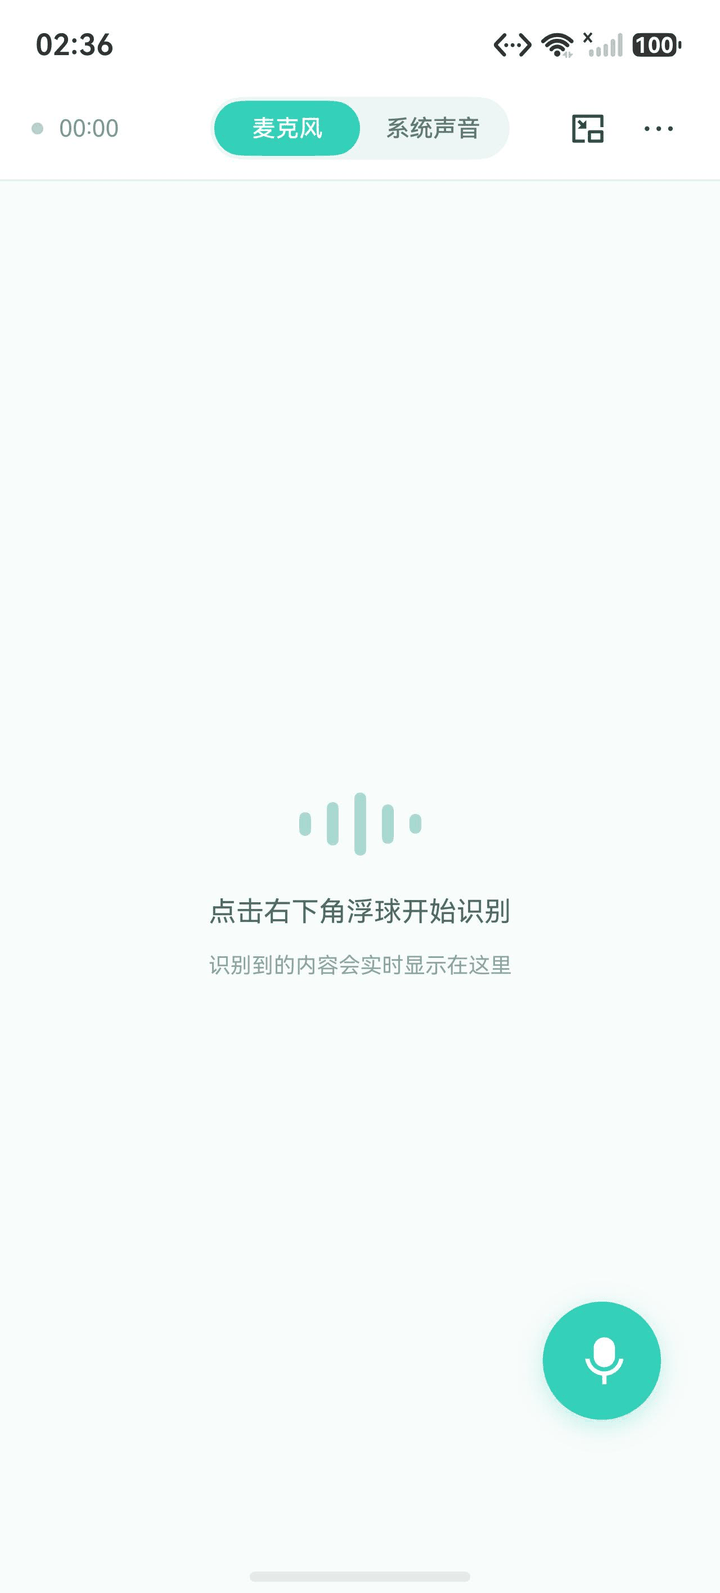
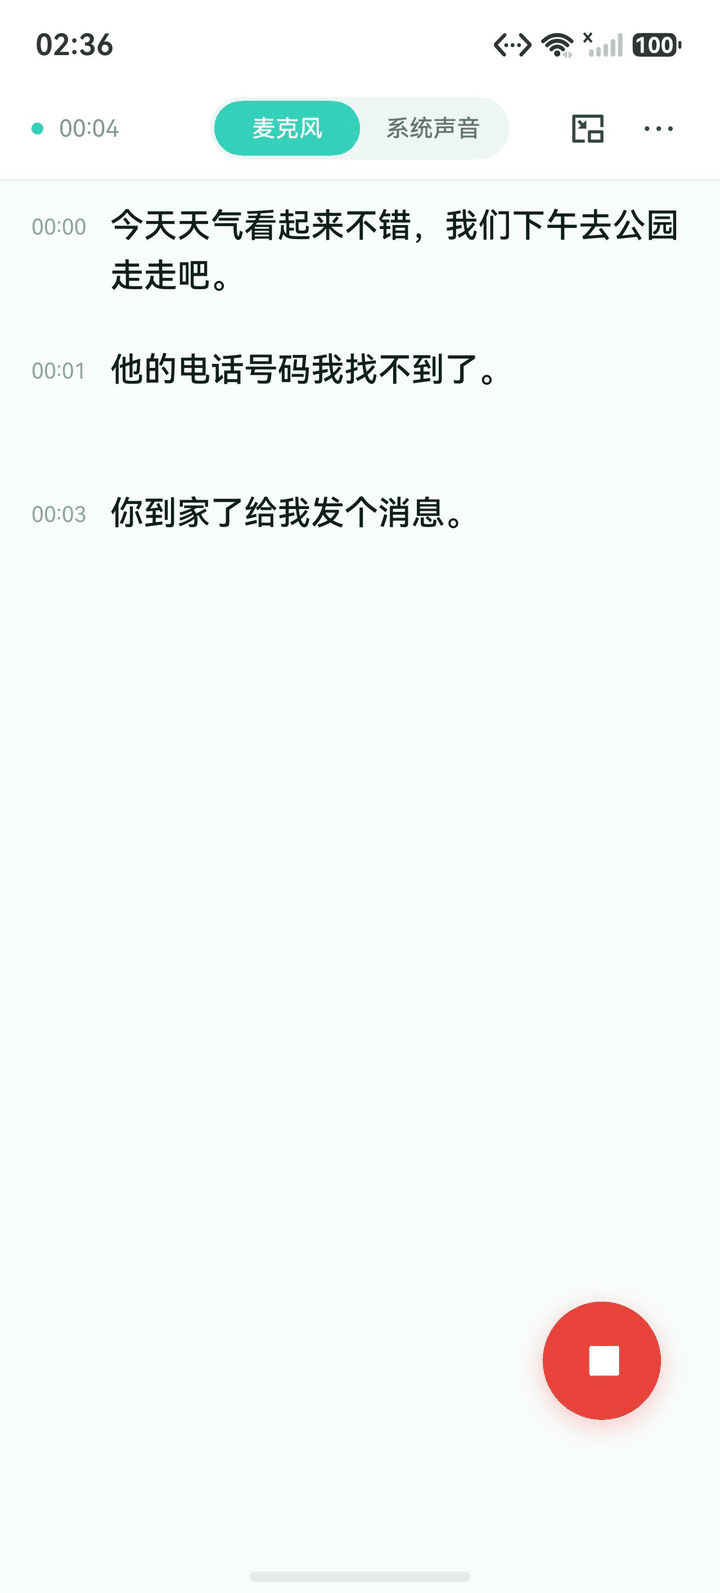
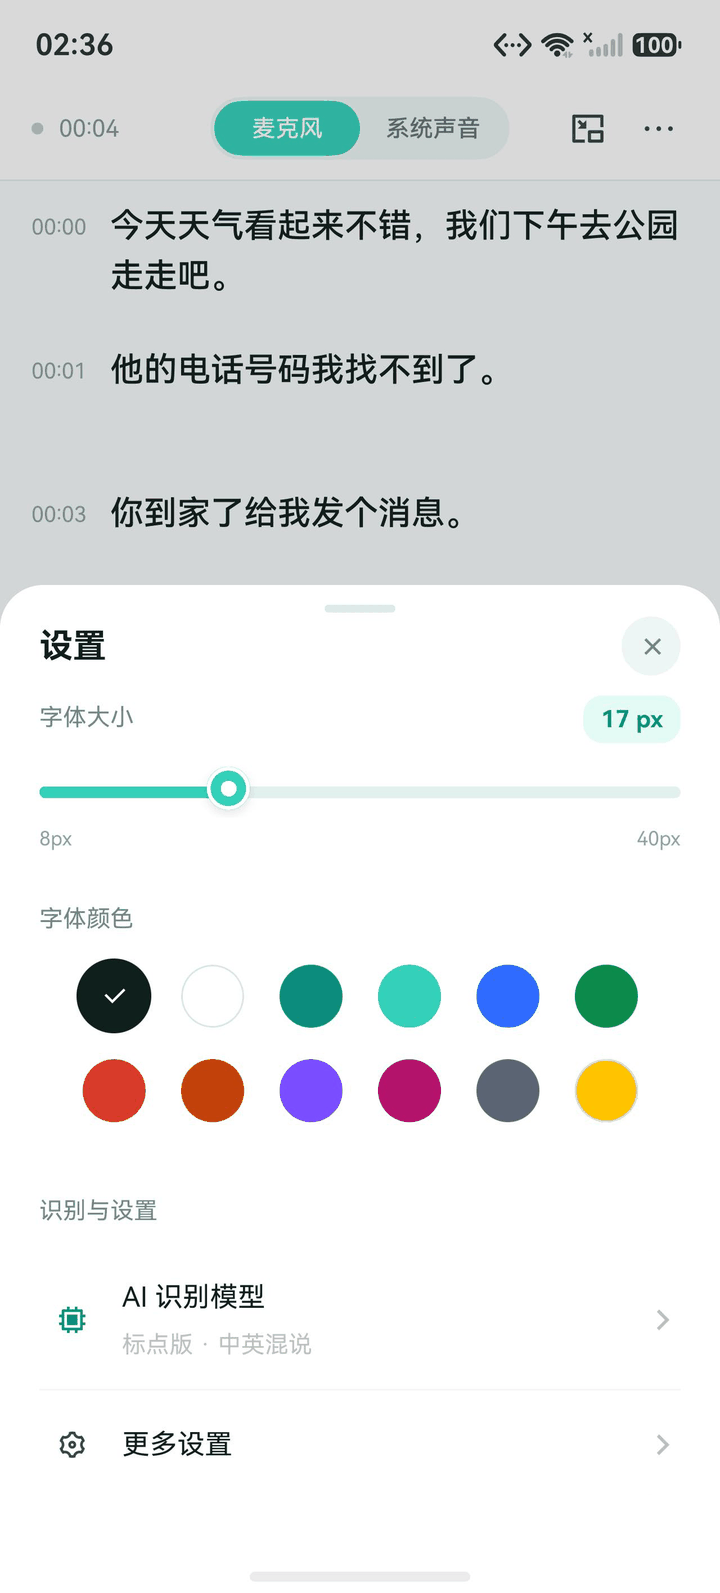
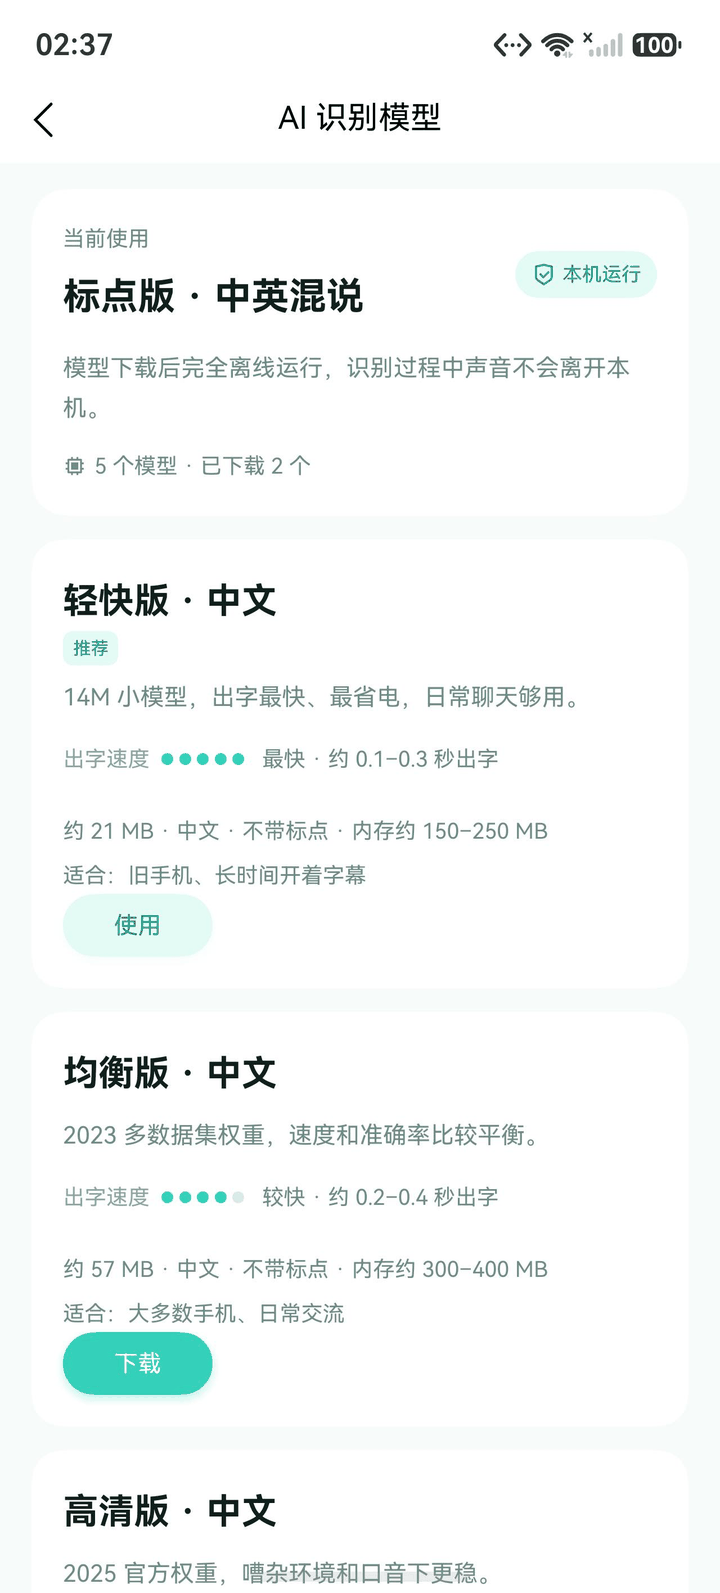
← 左右滑动查看更多 →
模型越大越准、越吃内存。不确定选哪个,先用轻快版 —— 老机型也能流畅跑。
字幕工具天然会接触最私密的对话。所以我们把它做成一个不需要信任任何服务器的产品。
没有账号体系,不用手机号或邮箱登录。不读取通讯录、短信、相册、通话记录,也不获取地理位置。
麦克风、系统声音、悬浮窗 —— 每一项都对应一个具体功能,拒绝任意一项其余功能仍可用。
声音以流的形式直接送进手机里的识别模型,识别完立即丢弃。不写录音文件,不上传,程序内也没有统计或崩溃上报 SDK。
字号、字色、所选模型、已下载模型清单,全部保存在应用私有目录,卸载即清除。
选择你的设备,看安装方式。App 本体免费,无会员、无广告。
安装包正在应用市场上架审核中。需要提前体验,可发邮件申请内测包。
手机扫码安装
上架后此处放 Android 下载二维码,扫码直接安装。
App Store 版本正在审核,通过后可直接搜索「听语字幕」下载。
App Store 链接
上架后此处放 App Store 二维码,扫码跳转下载。
鸿蒙原生版本开发完成,正在华为应用市场提交审核。
应用市场链接
上架后此处放鸿蒙版下载二维码。
App 免费,没有会员、没有广告、没有使用次数限制。模型下载到手机之后,识别过程不再产生任何网络流量。
识别过程完全离线。只有在首次下载语音模型时需要联网,模型下载完成后,识别、出字、悬浮显示全部在本机完成,飞行模式下也能正常使用。
不会。音频以流的形式直接送入本机识别模型,识别完成后立即丢弃,不写入录音文件,也不上传到任何服务器。
App 不设账号体系,不需要手机号或邮箱登录,因此也无法把你的使用记录与身份对应起来。
可以。除了麦克风收音,还支持把手机正在播放的系统声音转成字幕,用于视频、网课、通话外放等场景。
该能力由系统提供,部分机型需要在录屏或无障碍设置中单独开启,开启时状态栏可能出现录制提示,这是系统行为。
支持。标点版模型边说边自动补标点,适合看长句字幕;双语版基于 Paraformer 结构,中文里夹英文也能识别。
另外还有轻快版、均衡版、高清版三种纯中文模型,可按手机性能与准确率需求自由切换。
轻快版模型只有约 21MB,内存占用约 150–250MB,几年前的老机型也能流畅运行。
如果手机性能较好、更在意准确率,可以在设置里切换到高清版或标点版。
可以。开启「悬浮字幕」并授予悬浮窗权限后,字幕条会绘制在屏幕最上层,切换到其他应用也能看见。
该权限只用于显示字幕窗口,不读取其他应用的内容。
使用问题、准确率反馈、商务合作都欢迎。服务时间:周一至周日 9:00 – 21:00。